

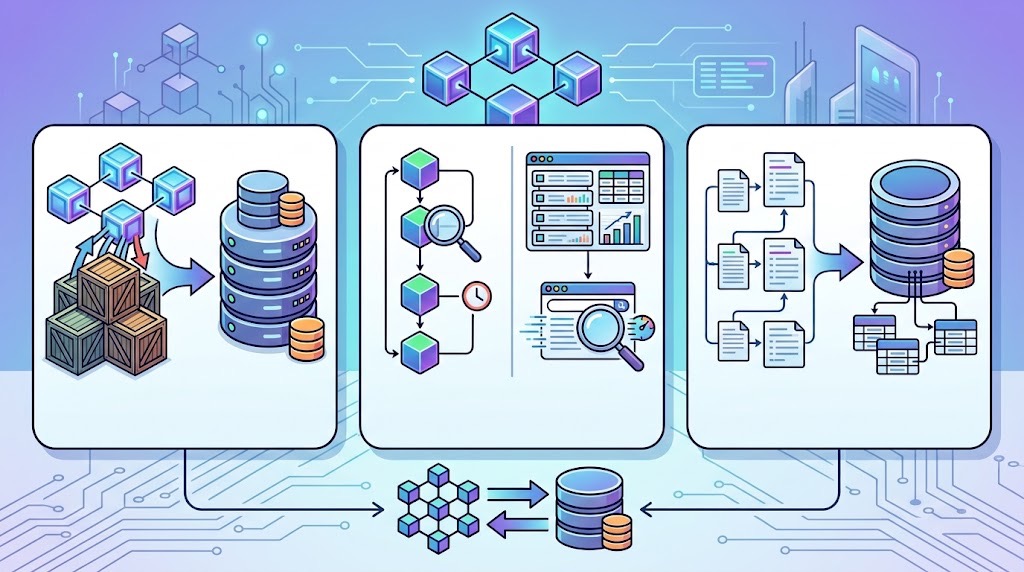
Uma blockchain é frequentemente descrita como uma base de dados distribuída, o que pode fazer soar contraditória a ideia de uma blockchain precisar de uma base de dados. Se a blockchain já armazena transações e estado, por que adicionar outra camada de armazenamento? A distinção torna-se mais clara ao observar como uma blockchain realmente funciona. A blockchain define um histórico partilhado e as regras para alcançar consenso, enquanto os nós individuais precisam de software capaz de armazenar, atualizar e recuperar essa informação de forma eficiente.
Os clientes de execução do Ethereum, por exemplo, gerem o estado da blockchain localmente e utilizam bases de dados persistentes para armazenar as estruturas de dados subjacentes. O Geth divide os blocos e estados recentes num armazenamento rápido de chave-valor — historicamente o LevelDB, sendo o Pebble o padrão nas versões atuais — enquanto move os dados “antigos” para um armazenamento separado, o freezer. As bases de dados, portanto, não substituem a camada de consenso da blockchain; elas fornecem a maquinaria de armazenamento que permite aos clientes blockchain operar a velocidades práticas.
Principais Conclusões
- As blockchains fornecem consenso e integridade criptográfica, enquanto as bases de dados tratam de grande parte do armazenamento e recuperação local de dados.
- Os nós precisam de bases de dados para aceder ao estado da blockchain sem processar repetidamente toda a cadeia.
- As estruturas de bases de dados tornam práticas as leituras e escritas frequentes à medida que o estado da blockchain cresce.
- A indexação e o armazenamento especializado permitem que os nós e as aplicações recuperem dados úteis de forma eficiente.
- O Ethereum e o Bitcoin demonstram como os clientes blockchain combinam dados de consenso com tecnologia de bases de dados convencional.
1. As Bases de Dados Tornam os Dados da Blockchain Acessíveis
Uma blockchain pode conter milhões ou milhares de milhões de peças individuais de informação, mas os nós não podem dar-se ao luxo de percorrer todo o histórico sempre que precisam de um valor. Uma base de dados dá ao nó uma estrutura persistente para localizar registos específicos rapidamente.
O Bitcoin oferece um exemplo simples através do Bitcoin Core, que mantém uma base de dados de chainstate contendo o conjunto atual de saídas de transação não gastas, ou UTXOs. Quando o software valida uma transação, precisa de determinar se as suas entradas se referem a saídas que podem ser gastas, e uma estrutura de base de dados adequada permite ao nó realizar essas pesquisas sem percorrer repetidamente todas as transações históricas.
O Bitcoin Core 0.15.0, lançado em 2017, mudou a base de dados de chainstate de um modelo por transação para um modelo por saída, o que tornou o download inicial de blocos e a reindexação cerca de 30% a 40% mais rápidos e reduziu o uso de memória entre 10% e 20%, ao custo de uma base de dados em disco cerca de 15% maior. O Ethereum enfrenta um problema de gestão de estado mais complicado porque o seu estado inclui contas, saldos, código de contratos e armazenamento de contratos. A camada de execução organiza este estado utilizando Merkle Patricia Tries, mas a própria trie depende de uma base de dados de chave-valor subjacente para persistir os seus nós. A documentação do Ethereum distingue explicitamente entre percorrer a trie e realizar a pesquisa subjacente na base de dados. Esta separação é importante porque as estruturas de dados criptográficas fornecem verificabilidade, enquanto os motores de bases de dados fornecem persistência e recuperação eficientes.
2. As Bases de Dados Permitem que os Nós Giram Estados em Mudança
Os dados da blockchain não se acumulam simplesmente como uma sequência imutável de blocos, uma vez que os contratos inteligentes, saldos de contas e UTXOs mudam constantemente à medida que as transações são executadas. Os nós precisam, portanto, de manter uma representação atual do estado enquanto preservam informação histórica suficiente para validar a cadeia.
O modelo de transição de estado do Ethereum ilustra o problema, uma vez que cada bloco válido move o estado da rede de um estado para outro após a execução das suas transações. O estado resultante é representado por uma Merkle Patricia Trie cuja raiz é registada no cabeçalho do bloco, e se um nó calcular uma raiz de estado diferente da do proponente do bloco, o compromisso criptográfico resultante será diferente e o bloco falhará na validação.
A base de dados por baixo desta estrutura armazena as peças individuais necessárias para reconstruir e atualizar esse estado. Os clientes de execução do Ethereum podem, portanto, modificar partes específicas do estado sem reconstruir todo o conjunto de dados do zero.
Esta abordagem também reduz trabalho de armazenamento desnecessário, porque a estrutura Merkle do Ethereum permite que partes inalteradas do estado permaneçam referenciadas enquanto as partes novas ou modificadas recebem hashes atualizados. A base de dados subjacente persiste essas estruturas para que o cliente possa recuperá-las ao processar blocos subsequentes. Sem uma camada de armazenamento persistente eficiente, cada transição de estado imporia um encargo computacional e de acesso a disco muito mais pesado sobre os nós.
3. As Bases de Dados Tornam os Dados da Blockchain Úteis Para Além do Consenso
O consenso não exige todas as formas possíveis de consultar dados da blockchain, uma vez que o protocolo essencialmente precisa que os nós verifiquem transações, mantenham um estado válido e concordem sobre a cadeia canónica. As aplicações, carteiras, exploradores e plataformas de análise frequentemente precisam de consultas muito mais ricas.
Uma blockchain pode responder a questões como se uma transação existe ou o que o estado atual indica, mas as aplicações frequentemente precisam de recuperar transações por endereço, identificar transferências ao longo de um determinado período, calcular saldos ou organizar atividade histórica em conjuntos de dados pesquisáveis. Estas tarefas beneficiam de índices e bases de dados orientadas a consultas construídas em torno dos dados da blockchain.
É por isso que a pilha de dados da blockchain frequentemente contém várias camadas, com um nó a manter a blockchain canónica e o seu estado enquanto sistemas de indexação separados transformam esses dados em estruturas otimizadas para consultas de aplicações. O próprio Ethereum documenta várias estratégias diferentes de armazenamento de dados de blockchain, incluindo calldata, eventos, armazenamento de contratos e blobs, porque diferentes tipos de informação têm diferentes requisitos de acessibilidade e persistência.
O mesmo princípio aparece no software do Bitcoin, onde o Bitcoin Core oferece um índice opcional de filtros de blocos que os operadores devem ativar, juntamente com outras capacidades de indexação que permitem às aplicações localizar informação relevante da blockchain sem percorrer toda a cadeia a cada pedido. Esta distinção torna-se cada vez mais importante à medida que as aplicações blockchain escalam, porque o armazenamento otimizado para consenso e o armazenamento otimizado para aplicações resolvem problemas diferentes, e forçar um único sistema a desempenhar ambas as funções pode gerar custos de desempenho desnecessários.
Por Que a Blockchain e a Tecnologia de Bases de Dados Trabalham Juntas
Chamar a uma blockchain uma base de dados distribuída é tecnicamente razoável, mas isso não significa que um cliente blockchain opere sem tecnologia de bases de dados convencional. A blockchain fornece propriedades como consenso descentralizado, compromissos criptográficos e uma ordenação partilhada de transações. Os sistemas de bases de dados fornecem armazenamento persistente, indexação, cache e acesso eficiente à informação exigida por cada nó.
O Ethereum demonstra esta arquitetura de forma particularmente clara, representando o seu estado através de tries autenticadas criptograficamente, enquanto os clientes de execução usam bases de dados para persistir os dados subjacentes de estado e de blocos. O Bitcoin adota uma abordagem diferente, utilizando um modelo UTXO e um chainstate apoiado em base de dados para tornar prática a validação de transações.
A relação é, portanto, complementar, com a tecnologia blockchain a determinar que dados podem ser considerados válidos e como os participantes concordam com as alterações, enquanto a tecnologia de bases de dados determina como as máquinas individuais armazenam e recuperam essa informação de forma suficientemente eficiente para manter a rede em funcionamento.
Perguntas Frequentes (FAQs)
Uma blockchain é, em si mesma, uma base de dados?
Sim. Uma blockchain é uma estrutura de dados distribuída e replicada, com regras de consenso, mas os nós da blockchain podem ainda assim usar bases de dados convencionais internamente para armazenar e recuperar os seus dados de forma eficiente.
Por que o Ethereum usa uma base de dados?
Os clientes do Ethereum usam bases de dados persistentes para armazenar dados da blockchain e os nós que compõem estruturas como a Merkle Patricia Trie, o que permite acesso e atualizações de estado eficientes.
Que base de dados o Ethereum usa?
O Ethereum é um protocolo, não uma única implementação de software, pelo que os seus clientes podem usar diferentes tecnologias de armazenamento. O Geth, por exemplo, mantém os blocos e o estado recentes num armazenamento rápido de chave-valor — LevelDB em versões mais antigas e Pebble por padrão nas versões atuais — enquanto envia dados mais antigos para um armazenamento separado, o freezer.
Por que o Bitcoin precisa de uma base de dados?
O Bitcoin Core usa uma base de dados de chainstate para rastrear o conjunto atual de UTXOs, permitindo aos nós determinar quais saídas continuam disponíveis para serem gastas sem percorrer repetidamente toda a blockchain.
Qual é a diferença entre o armazenamento em blockchain e uma base de dados?
O armazenamento em blockchain é regido por consenso e compromissos criptográficos, enquanto uma base de dados fornece os mecanismos locais usados para persistir, organizar, indexar e recuperar essa informação de forma eficiente.





Leave a Reply